hiệu năng, băng thông, tản nhiệt, k thấy heo quay cập nhật

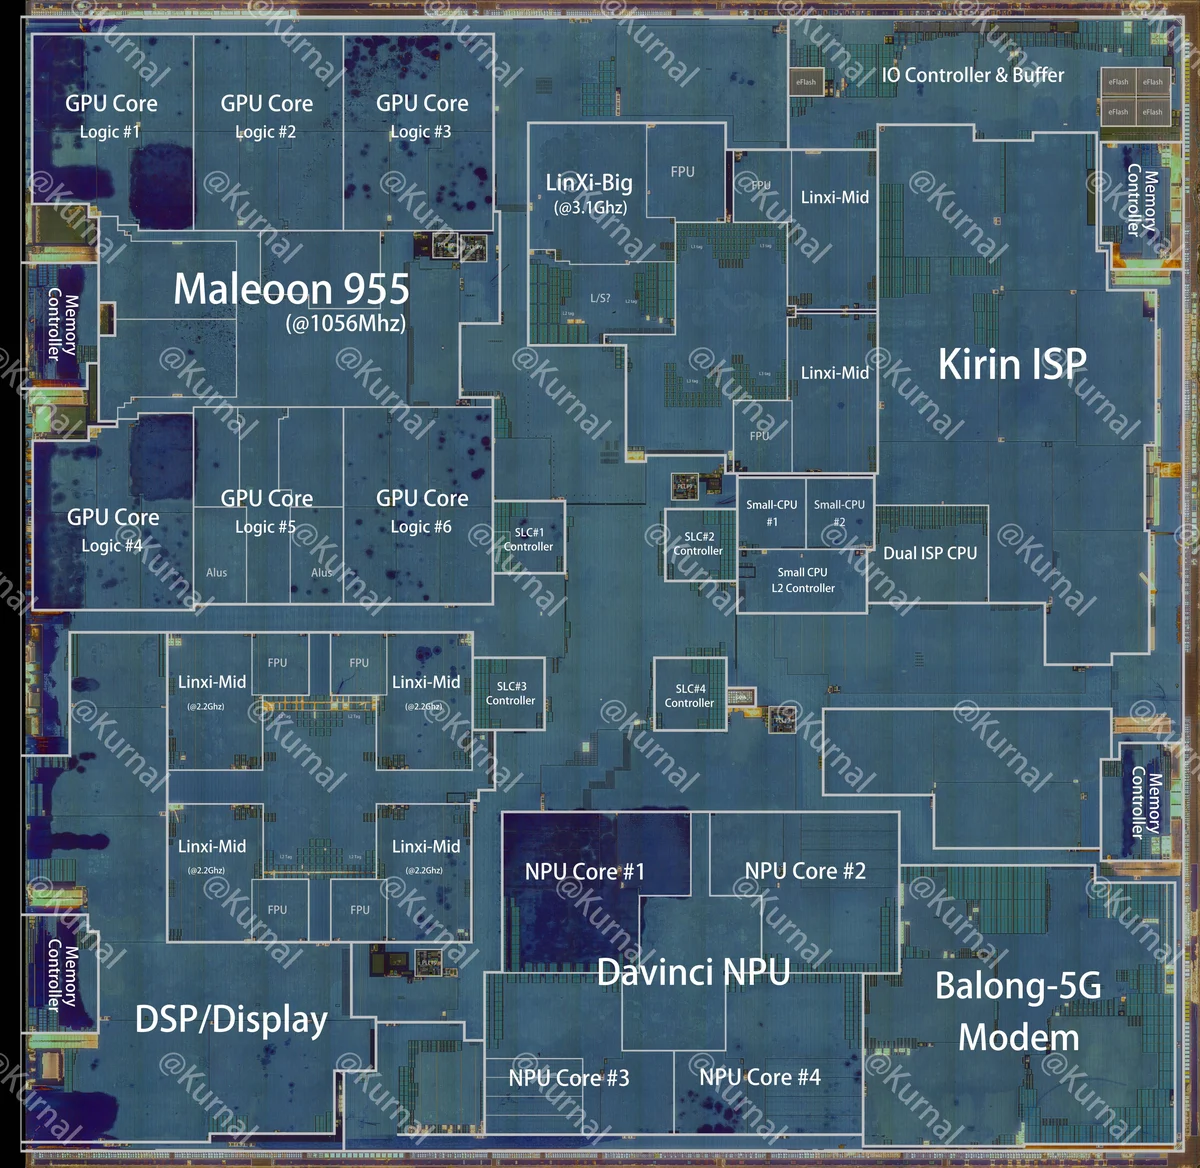
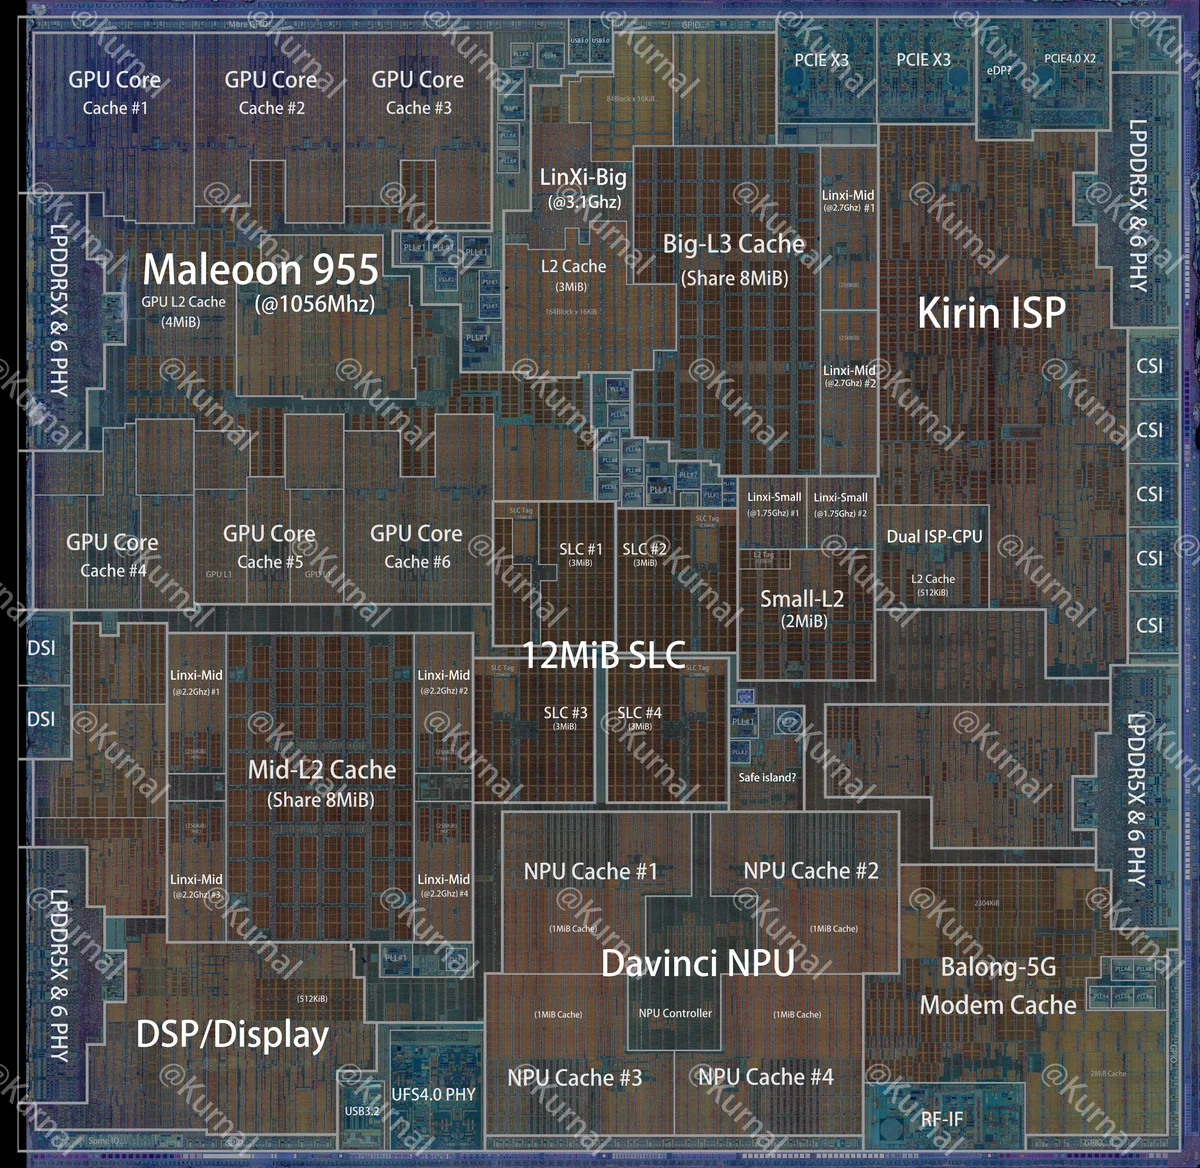
Die shot chip Kirin 9050 Pro từ Kurnal Insights cho thấy cách HUAWEI làm kiến trúc LogicFolding thực sự rất thú vị, đặc biệt là khi đặt cạnh tư duy của AMD.
HUAWEI không thể tiếp cận với các máy quang khắc thế hệ mới, tiên tiến nhất như EUV để thu nhỏ tiến trình, nên họ phải tận dụng triệt để những gì đang có từ đối tác gia công SMIC.
LogicFolding về bản chất là 2 die xếp chồng lên nhau: Compute Tile và SRAM. Compute Tile chứa các cụm nhân xử lý CPU, GPU, NPU sản xuất trên tiến trình SMIC N+3, còn SRAM phụ trách bộ nhớ đệm cache/SRAM sản xuất trên tiến trình SMIC N+2.
Cách làm của HUAWEI giúp tối ưu diện tích, vẫn tăng được mật độ bóng bán dẫn trong die chip nhỏ hơn mà không cần giảm tiến trình sản xuất, con số của HUAWEI là khoảng 238 triệu bóng bán dẫn trên một milimet vuông.
Tự nhiên nghĩ cách làm của HUAWEI khá tương đồng với AMD 3D V-Cache khi AMD cũng tách bộ đệm L3 ra thành một die mỏng rồi ép trực tiếp lên khuôn CCD chứa nhân CPU qua liên kết Direct Copper-to-Copper Hybrid Bonding, kết hợp TSV (Through-Silicon Vias).
Cách làm của AMD giải quyết bài toán khác HUAWEI, nói là bài toán của HUAWEI khó hơn AMD nhiều khi phải sống còn trong hoàn cảnh ngặt nghèo này.
7


Trong cái khó nó ló cái khôn. Cứ đà này 5 10 năm nữa có khi chíp của nó vượt mặt cả Rồng cả A chứ ko đùa .

TQ đáng sợ thật, mình nghĩ với tốc độ hiện tại, chỉ 5 hoặc 10 năm nữa họ sẽ bắt kịp hoặc vượt qua phương tây về công nghệ sản xuất chip. Có khi không tới 5 hay 10 năm nữa.

Quan trọng là nó đứng trên đôi chân của mình, ko sợ bố con thằng nào cả
- Chịu trách nhiệm nội dung: Trần Mạnh Hiệp
- © 2026 Công ty Cổ phần MXH Tinh Tế
- Địa chỉ: 351/56 Lê Văn Sỹ, P. Nhiêu Lộc, Tp HCM
- Số điện thoại: 02822460095
- MST: 0313255119
- Giấy phép cung cấp dịch vụ MXH số 41/GP-BVHTTDL, Ký ngày: 25/03/2026