

RTX 4090 — card đồ họa với GPU mạnh hơn bất kỳ thứ gì Apple từng nhét vào laptop — lại chạy mô hình ngôn ngữ lớn (LLM) Llama 3.3 70B chậm hơn gần 3 lần so với MacBook Pro M5 Max. Cụ thể: RTX 4090 chỉ sinh được khoảng 10 token/giây, còn M5 Max đạt ước tính 30–35 token/giây (theo Spheron, Skorppio).
Mình mất một lúc mới hiểu ra: đây không phải câu hỏi "GPU nào mạnh hơn". Đây là câu chuyện về bộ nhớ — và về một hiện tượng mà mình gọi tắt là "vực thẳm VRAM," thứ quyết định ai thắng trong kịch bản này mà ít bài giải thích thẳng.
Nhưng cũng phải nói ngay: RTX PRO 6000 Blackwell với 96 GB bộ nhớ đồ họa chuyên biệt lại bỏ xa M5 Max một khoảng cách không thể lấp đầy. Bài này mình sẽ giải thích cả hai chiều đó, không thiên vị bên nào.
Apple thiết kế chip M5 Max bằng cách đặt CPU 18 nhân, GPU tối đa 40 nhân, và bộ tăng tốc AI (Neural Engine) 16 nhân vào cùng một mảnh silicon trên tiến trình 3nm của TSMC — rồi cho chúng dùng chung một bể bộ nhớ LPDDR5X-9600 duy nhất, tối đa 128 GB (theo Apple Newsroom, Wikipedia).
Cách tổ chức này gọi là Kiến trúc bộ nhớ thống nhất — viết tắt là UMA. Không có "phần RAM của CPU" và "phần bộ nhớ đồ họa của GPU" — chỉ có một bể bộ nhớ mà mọi đơn vị xử lý đều truy cập trực tiếp.
Mình mất một lúc mới hiểu ra: đây không phải câu hỏi "GPU nào mạnh hơn". Đây là câu chuyện về bộ nhớ — và về một hiện tượng mà mình gọi tắt là "vực thẳm VRAM," thứ quyết định ai thắng trong kịch bản này mà ít bài giải thích thẳng.
Nhưng cũng phải nói ngay: RTX PRO 6000 Blackwell với 96 GB bộ nhớ đồ họa chuyên biệt lại bỏ xa M5 Max một khoảng cách không thể lấp đầy. Bài này mình sẽ giải thích cả hai chiều đó, không thiên vị bên nào.
Bộ nhớ chung hay bộ nhớ riêng — hai triết lý thiết kế hoàn toàn khác nhau
UMA: một bể bộ nhớ, mọi đơn vị xử lý cùng dùng
Apple thiết kế chip M5 Max bằng cách đặt CPU 18 nhân, GPU tối đa 40 nhân, và bộ tăng tốc AI (Neural Engine) 16 nhân vào cùng một mảnh silicon trên tiến trình 3nm của TSMC — rồi cho chúng dùng chung một bể bộ nhớ LPDDR5X-9600 duy nhất, tối đa 128 GB (theo Apple Newsroom, Wikipedia).
Cách tổ chức này gọi là Kiến trúc bộ nhớ thống nhất — viết tắt là UMA. Không có "phần RAM của CPU" và "phần bộ nhớ đồ họa của GPU" — chỉ có một bể bộ nhớ mà mọi đơn vị xử lý đều truy cập trực tiếp.
Ý nghĩa thực tế: khi GPU cần dữ liệu mà CPU vừa chuẩn bị, nó đọc thẳng từ địa chỉ bộ nhớ đó — không cần sao chép dữ liệu qua bất kỳ đường bus trung gian nào. Apple gọi cơ chế này là "zero-copy," và nó loại bỏ hoàn toàn chi phí truyền dữ liệu vốn là điểm yếu cố hữu của kiến trúc phân tách.
Card rời Nvidia: bộ nhớ đồ họa siêu nhanh nhưng hoàn toàn biệt lập
Kiến trúc máy trạm Windows truyền thống đi theo hướng ngược lại — tách biệt hoàn toàn hai loại bộ nhớ: RAM hệ thống dùng cho CPU, và bộ nhớ đồ họa (VRAM) hàn trực tiếp trên card, dùng riêng cho GPU.
Khi GPU cần xử lý dữ liệu lớn, dữ liệu phải đi theo hành trình: ổ cứng → RAM hệ thống → VRAM — và điểm nối giữa hai loại bộ nhớ đó là khe cắm PCIe. Khe PCIe Gen 5 x16 thế hệ mới nhất có băng thông lý thuyết khoảng 64 GB/giây — nghe có vẻ nhanh, nhưng so sánh với băng thông VRAM nội bộ sẽ thấy vấn đề ngay.
VRAM thì rất nhanh và không bị tranh chấp bởi CPU. Dù vậy, nó bị cô lập với phần còn lại của hệ thống bởi chính cái khe PCIe đó — và đây là điểm mấu chốt.
Con số băng thông: ai đang "chia sẻ" và ai được toàn quyền
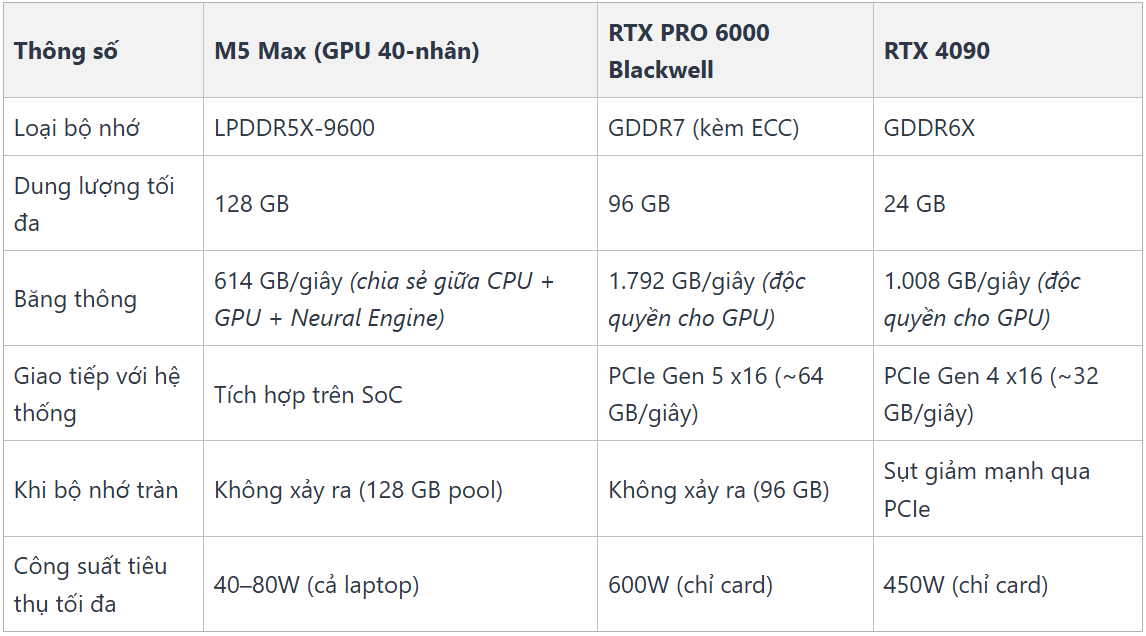
M5 Max cấu hình GPU 40-nhân đạt băng thông tối đa 614 GB/giây — con số ấn tượng với một máy tính cá nhân (theo Apple Newsroom). Nhưng đây là băng thông chia sẻ giữa CPU, GPU và Neural Engine — cả ba cùng tranh nhau qua một đường truyền, được điều phối bởi bộ phân phối bộ nhớ tích hợp trên chip. Khi hệ thống đang chạy nhiều tác vụ nặng đồng thời, băng thông thực sự cung cấp riêng cho GPU thấp hơn con số lý thuyết này.
Nguồn: Apple Newsroom, Nvidia.com, Wikipedia
Quảng cáo
RTX PRO 6000 Blackwell có băng thông 1.792 GB/giây — gần 1,8 TB/giây — và con số đó hoàn toàn dành cho GPU, không ai cạnh tranh (theo Nvidia). RTX 4090 đạt 1.008 GB/giây chuyên biệt. Nhìn vào thì Nvidia thắng rõ về băng thông thô. Thực ra thì con số thô không kể được toàn bộ câu chuyện — và đây là lý do tại sao.
Vực thẳm VRAM — thứ ít ai giải thích nhưng quyết định tất cả
Đây là phần quan trọng nhất bài.
Mô hình ngôn ngữ lớn có kích thước cụ thể tính bằng gigabyte — đó là lượng bộ nhớ cần để nạp toàn bộ trọng số vào bộ xử lý. Llama 3.3 70B ở định dạng nén 4-bit cần khoảng 42 GB.
Vấn đề với RTX 4090: card này chỉ có 24 GB bộ nhớ đồ họa. Khi mô hình 42 GB cần chạy, khoảng 20 GB phần còn lại phải "tràn" ra RAM hệ thống — và GPU phải với tay qua khe cắm PCIe mỗi khi cần đọc phần tràn đó.
Tốc độ bên trong VRAM của RTX 4090: 1.008 GB/giây.
Tốc độ truy cập qua PCIe Gen 4 x16: ~32 GB/giây.
Chênh lệch: hơn 30 lần.
Quảng cáo
Khi bộ nhớ đồ họa tràn, GPU liên tục gặp phải các lỗi trang bộ nhớ — mỗi lần cần dữ liệu nằm ngoài VRAM, nó phải dừng lại và chờ chuyển qua khe PCIe. Kết quả: tốc độ sinh từ của RTX 4090 sụt xuống còn khoảng 10 token/giây trên Llama 3.3 70B, thời gian phản hồi đầu tiên vượt 2 giây (theo Spheron).
Cái đáng lo hơn: sự sụt giảm này không diễn ra dần dần. Mô hình 14B chạy được 40 token/giây; mô hình 30B tràn bộ nhớ chỉ còn 3–5 token/giây — giảm 8–13 lần trong nháy mắt (theo Spheron). Không phải giảm đều — mà rơi xuống vực. Đó là lý do mình gọi hiện tượng này là vực thẳm VRAM.
M5 Max 128 GB không gặp vấn đề này. Toàn bộ 42 GB của Llama 3.3 70B nằm gọn trong bộ nhớ thống nhất, GPU truy cập ổn định ở 614 GB/giây mà không qua bất kỳ bus trung gian nào. Kết quả ước tính: ~30–35 token/giây — dựa trên M4 Max thực đo 28 tok/s và mức cải thiện băng thông giữa hai thế hệ (theo Spheron, Skorppio).
Có một câu từ phân tích của Spheron mình thấy nói đúng vấn đề: "không phải bộ nhớ nhanh nhất của bạn chạy nhanh cỡ nào — mà là bộ nhớ chứa mô hình của bạn chạy nhanh cỡ nào." M5 Max thắng RTX 4090 ở đây không phải vì GPU Apple mạnh hơn — mà vì nó có đủ chỗ để giữ toàn bộ mô hình gần bộ xử lý, còn RTX 4090 thì không.
Nghịch lý hơn nữa: RTX 5090 — card mạnh hơn RTX 4090 và có 32 GB bộ nhớ đồ họa — còn tệ hơn khi chạy mô hình 70B+, chỉ đạt 2,3–4,7 token/giây vì phần tràn ra nhiều hơn (theo arXiv). Trong khi đó Apple M3 Ultra — thế hệ cũ hơn M5 Max — đạt 13,1–49,1 token/giây trên cùng loại mô hình với bộ nhớ thống nhất đủ lớn (theo arXiv).
Khi mô hình nhỏ: GPU rời Nvidia thắng 2–3 lần
Mình cũng phải thành thật một điều: kịch bản trên chỉ xảy ra khi mô hình quá lớn so với bộ nhớ đồ họa.
Với mô hình 7B hay 13B — phổ biến nhất hiện nay và dễ dàng nằm gọn trong 24 GB bộ nhớ đồ họa của RTX 4090 — GPU rời thắng rõ ràng. Tốc độ sinh từ trên Nvidia ở tầm 100–150 token/giây; M5 Max chỉ đạt khoảng 40–50 token/giây (theo Skorppio).
Lý do: khi mô hình nằm gọn trong bộ nhớ đồ họa, GPU Nvidia khai thác toàn bộ hơn 1.000 GB/giây băng thông chuyên biệt mà không ai tranh chấp. M5 Max — dù không có vực thẳm VRAM — cũng không đủ sức mạnh tính toán thô để bắt kịp trong điều kiện này.
Thêm một điểm đáng biết: giai đoạn xử lý đầu vào — tức là khi hệ thống đọc và phân tích toàn bộ câu hỏi trước khi bắt đầu trả lời — M5 Max nhanh hơn M4 Max tới 4 lần nhờ các khối tăng tốc AI mới tích hợp vào từng nhân GPU (theo Apple Newsroom). Nhưng giai đoạn này chỉ xảy ra một lần đầu; phần quyết định trải nghiệm thực tế là tốc độ sinh từ, và ở đó M5 Max cải thiện khiêm tốn hơn nhiều — khoảng 19–24% so với M4 Max — do bị giới hạn bởi băng thông bộ nhớ chứ không phải sức mạnh tính toán (theo Skorppio, MLX benchmark của Apple).
96 GB bộ nhớ chuyên biệt — Blackwell xóa sổ vực thẳm
Vậy Nvidia giải bài toán này bằng cách nào? Đơn giản: nâng dung lượng bộ nhớ đồ họa lên đủ lớn để mô hình không bao giờ phải tràn ra ngoài.
RTX PRO 6000 Blackwell Workstation Edition mang 96 GB GDDR7 với ECC — tính năng tự kiểm tra và sửa lỗi bộ nhớ quan trọng trong môi trường chuyên nghiệp (theo Nvidia). Llama 3.3 70B cần 42 GB — fit thoải mái, không tràn một byte nào. Khi đó toàn bộ 1.792 GB/giây băng thông chuyên biệt phục vụ hoàn toàn cho tác vụ suy luận. Kết quả: tốc độ vượt 100 token/giây — bỏ xa M5 Max.
Hơn nữa, hệ sinh thái CUDA với hơn 20 năm phát triển tạo ra lợi thế mà Apple chưa thể san bằng trong ngắn hạn. PyTorch, TensorFlow, TensorRT-LLM đều được tối ưu cho CUDA trước tiên. Và một điểm kỹ thuật quan trọng hơn: thuật toán FlashAttention — giúp giảm mạnh lượng bộ nhớ đệm cần dùng khi xử lý chuỗi văn bản rất dài — chạy hoàn hảo trên CUDA, nhưng Metal của Apple chưa có giải pháp tương đương (theo Workstation.be). Điều đó có nghĩa là khi cần chạy mô hình với cửa sổ ngữ cảnh hàng trăm ngàn token — tóm tắt tài liệu dài, phân tích hàng ngàn trang code — M5 Max sẽ bị hạn chế do bộ nhớ đệm phình to quá mức. Đây là điểm yếu đáng kể mà ít bài so sánh đề cập thẳng.
Tóm lại phương trình sau khi Blackwell vào cuộc:
- Mô hình nhỏ (7B–13B, fit trong bộ nhớ đồ họa thông thường): Nvidia thắng 2–3 lần
- Mô hình vừa (30B–70B, tràn bộ nhớ đồ họa thông thường): M5 Max thắng nhờ 128 GB bộ nhớ thống nhất
- Mô hình vừa–lớn (30B–70B+, fit gọn trong 96 GB Blackwell): RTX PRO 6000 Blackwell thắng tuyệt đối
Dựng hình 3D và dựng phim — lại là chuyện khác hẳn
Blender: không có gì phức tạp để phân tích
Trong tác vụ dựng hình 3D bằng Blender, khoảng cách còn lớn hơn và không cần giải thích nhiều.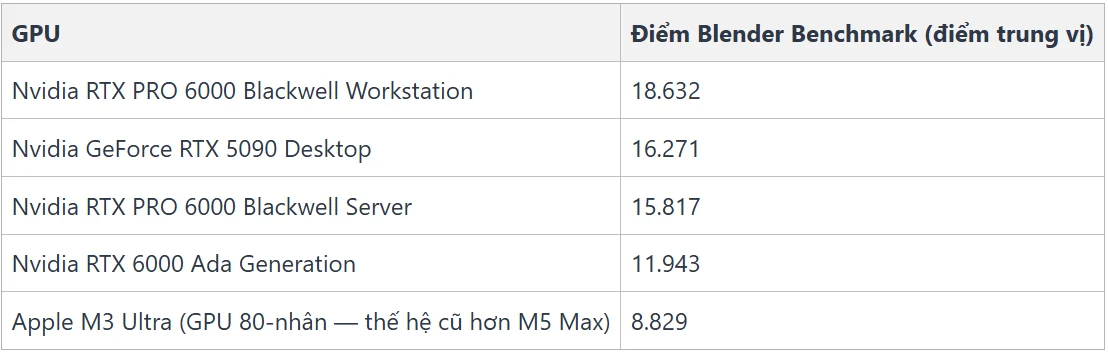
Nguồn: Blender Open Data
M5 Max 40-nhân chưa có điểm chính thức trên Blender Open Data. Có dữ liệu không chính thức từ Reddit cho thấy M5 Max bám đuổi RTX 5090 laptop trong Blender 5.1 — nhưng RTX 5090 desktop hay RTX PRO 6000 dùng điện năng cao gấp nhiều lần và để lộ khoảng cách rõ ràng hơn nhiều.
Lý do đơn giản: card đồ họa rời dùng điện nhiều hơn → trang bị được nhiều nhân đồ họa hơn → dựng hình nhanh hơn. Với tác vụ render kéo dài hàng giờ, sức mạnh thô vẫn là thứ quyết định. M5 Max giỏi nhiều thứ — nhưng đây không phải trận đấu của nó.
Dựng video: Media Engine còn mạnh, Blackwell vừa thêm một quân bài mới
Đây là lĩnh vực M5 Max thể hiện rất tốt. Bộ tăng tốc đa phương tiện (Media Engine) tích hợp sẵn trên chip hỗ trợ phần cứng cho ProRes, ProRes RAW, H.264, HEVC — chỉnh sửa footage 4K ProRes trên Final Cut Pro hay DaVinci Resolve mượt mà không cần file proxy, tiêu thụ điện rất thấp.
Nhưng Blackwell vừa thêm một quân bài đáng chú ý: bộ mã hóa NVENC thế hệ 9 và bộ giải mã NVDEC thế hệ 6 lần đầu tiên hỗ trợ giải mã phần cứng H.264 4:2:2 10-bit — định dạng ghi hình tiêu chuẩn của hầu hết máy quay chuyên nghiệp hiện nay (theo Puget Systems). Trước đây định dạng này bắt buộc phải giải mã bằng CPU trên Windows, gây nghẽn toàn hệ thống. Nay DaVinci Resolve hay Premiere Pro có thể xử lý thẳng file quay gốc mà không cần chuyển mã sang định dạng trung gian.
Với editor dùng Final Cut Pro trên macOS — M5 Max vẫn là lựa chọn tự nhiên nhất. Với editor dùng DaVinci Resolve và footage từ máy quay Sony, Blackmagic, hay Canon chuyên nghiệp trên Windows — Blackwell vừa thu hẹp đáng kể khoảng cách.
Tiền thật và điện thật của hai hệ thống
MacBook Pro M5 Max cấu hình cao nhất — 128 GB bộ nhớ thống nhất, 2 TB SSD — giá khoảng 5.099 USD: hệ thống hoàn chỉnh, sẵn dùng, mang đi được (theo Tom's Guide).
Card RTX PRO 6000 Blackwell: hơn 11.000 USD — và chỉ là card đồ họa. Để vận hành được nó cần thêm bo mạch chủ cao cấp hỗ trợ PCIe Gen 5, CPU đa nhân thế hệ mới, tối thiểu 128 GB RAM DDR5, nguồn điện 1.200–1.600W, vỏ case chuyên dụng. Tổng máy trạm đầy đủ vượt 14.000 USD (theo Nvidia, Newegg).
Chênh lệch chi phí điện mới là thứ ít người để ý. M5 Max tiêu thụ 40–80W khi chạy tác vụ AI nặng — cả laptop. Máy trạm với RTX PRO 6000 cần nguồn 1.200–1.600W để vận hành ổn định, riêng card đồ họa đã tiêu tối đa 600W (theo Nvidia). Vận hành 24/7 trong một năm — hóa đơn tiền điện chênh lệch nhau không phải con số nhỏ, chưa kể hệ thống làm mát phòng máy.
Nghiên cứu từ arXiv ghi nhận Apple M3 Ultra đạt hiệu quả năng lượng cao hơn RTX 5090 khoảng 23 lần khi tính theo token/joule — M5 Max còn hiệu quả hơn thế. Đây không phải điểm cộng nhỏ với cá nhân hay nhóm nhỏ cần vận hành liên tục mà không muốn hóa đơn điện leo thang (theo arXiv).
Câu hỏi quyết định thực tế
Sau khi đọc hết, mình thấy thứ cần hỏi không phải "UMA hay VRAM chuyên biệt?" — mà là: mô hình mình cần chạy có vừa vào bộ nhớ đồ họa của card không?
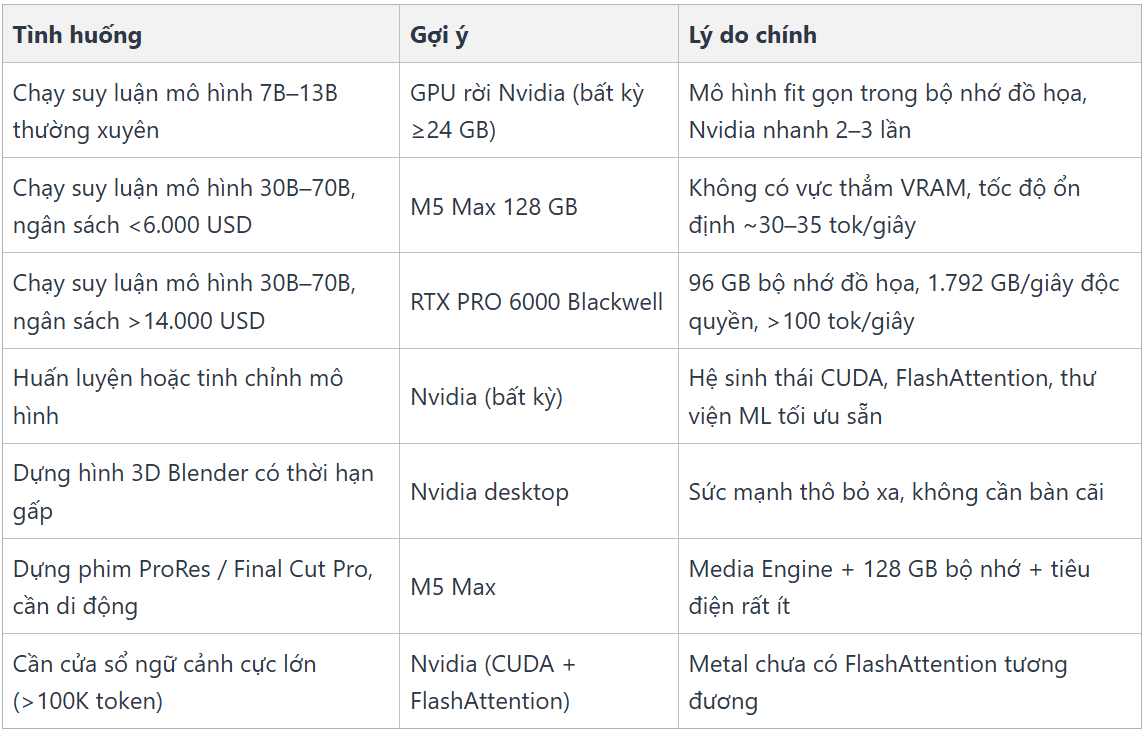
Một điểm nữa mình thấy quan trọng mà ít bài đề cập: với người cần huấn luyện hoặc tinh chỉnh lại mô hình — không chỉ chạy suy luận — câu trả lời hầu như luôn là Nvidia, bất kể dung lượng bộ nhớ. Không phải chỉ vì băng thông hay sức mạnh tính toán thô, mà vì toàn bộ hệ sinh thái PyTorch, TensorFlow, TensorRT-LLM được tối ưu cho CUDA trước tiên. Apple chưa có gì tương đương đủ trưởng thành ở thời điểm này.
M5 Max rất mạnh trong thế giới riêng của nó: suy luận cục bộ mô hình lớn, dựng phim chuyên nghiệp, di động và tiết kiệm điện. RTX PRO 6000 Blackwell rất mạnh trong thế giới của nó: sức mạnh tính toán cực đại, huấn luyện, dựng hình 3D. Hai thứ không thay thế nhau — chỉ phù hợp với bài toán khác nhau.
Nếu bạn đang cân nhắc MacBook Pro M5 Max cho tác vụ AI hay dựng phim, mình thấy macone.vn hay tư vấn theo hướng hỏi thẳng nhu cầu thực tế trước — tránh kiểu "cứ mua RAM nhiều nhất là xong" mà không hiểu bạn thực sự cần gì.
Anh em đang chạy mô hình AI gì trên máy — và cấu hình hiện tại của mình là gì? Mình tò mò liệu có ai đã thực sự so sánh M5 Max với card Nvidia ở dải giá tương đương trong điều kiện thực tế chưa, hay phần lớn vẫn phụ thuộc vào benchmark tổng hợp? Comment cho mình biết nhé!

#ai #llm #applem5max #nvidia #gpu #benchmark #macone
