

Mình có con số này đây: đoạn đầu vào phức tạp mà chip M4 mất 81 giây để nạp xong thì M5 chỉ mất 18 giây (theo Apple ML Research). Gần 4.5 lần - đủ để Apple đưa cái "4x faster AI" vào mọi bài thuyết trình ra mắt.
Nhưng rồi mình nhìn vào số tốc độ sinh từ - tức là khi mô hình đang đặt ra từng chữ một - và con số chỉ tăng 19-27% so với M4 (theo Apple ML Research). Cùng một chip, cùng một mô hình ngôn ngữ lớn, hai bài toán khác nhau, hai kết quả hoàn toàn khác nhau.
Tại sao vậy? Câu trả lời nằm trong cách chip M5 được thiết kế lại ở cấp độ vi mạch - và nó liên quan trực tiếp đến cái thứ Apple gọi là GPU Neural Accelerator.
Mình sẽ bóc tách ba thứ trong bài này: kiến trúc phần cứng thực sự thay đổi cái gì, con số "4 lần" đó áp dụng ở đâu và không áp dụng ở đâu, rồi đến câu hỏi kinh doanh mà ít bài nào hỏi thẳng - Apple đang tử tế với bạn hay chỉ đang rất khéo?
Từ đơn vị xử lý vector đến Neural Accelerator cái gì thực sự thay đổi trên silicon
Từ M1 đến M4, GPU của Apple không có phần cứng nhân ma trận chuyên dụng. Toàn bộ tính toán cho các mô hình AI chạy qua 128 đơn vị xử lý vector thông thường (ALU) trên mỗi lõi GPU - loại đơn vị thiết kế sẵn cho đồ họa, phải chia sẻ tài nguyên với các luồng kết xuất hình ảnh (theo Creative Strategies).
Hình dung thế này: xử lý ma trận theo kiểu đó giống như tính một bảng nhân khổng lồ bằng cách cộng từng ô một theo hàng. Mỗi bước, chip phải đọc dữ liệu từ bộ nhớ ngoài → tính → ghi kết quả trung gian lại vào bộ nhớ → đọc lên cho bước tiếp theo. Vòng lặp đó lặp lại hàng tỷ lần - phần lớn băng thông bộ nhớ tiêu hao chỉ để chuyển dữ liệu qua lại, không phải để tính toán thực sự.
Neural Accelerator trong M5 làm khác. Phần cứng mới này chia ma trận lớn thành các ô vuông nhỏ và xử lý chúng song song ngay trên bộ đệm của chip - dữ liệu tái sử dụng tại chỗ mà không phải đi ra ngoài bộ nhớ sau mỗi phép tính (theo tzakharko.github.io). Mỗi lõi GPU M5 chứa một Neural Accelerator có khả năng thực hiện 1.024 phép nhân-cộng tích lũy trên định dạng số 16-bit (FP16) mỗi chu kỳ xung nhịp (theo Apple ML Research).
M5 Max có 40 lõi GPU - tổng năng lực tính toán thô ước tính xấp xỉ 70 TFLOPS FP16, so với 18.4 TFLOPS của M4 Max khi dùng đơn vị xử lý vector thông thường (theo Skorppio). Đây là kiến trúc tương tự những gì NVIDIA làm với Tensor Core trên dòng GPU Volta từ 2017 - Apple thực hiện muộn hơn, nhưng tích hợp vào kiến trúc bộ nhớ thống nhất (Unified Memory) vốn đã là lợi thế riêng của Apple Silicon.
Đây là thay đổi thật ở cấp độ phần cứng. Không phải đổi tên, không phải tối ưu phần mềm.
Tại sao "4 lần nhanh hơn" chỉ đúng trong vài chục giây đầu
Khi chạy một mô hình ngôn ngữ lớn, hệ thống thực ra đang làm hai việc hoàn toàn khác nhau về bản chất.
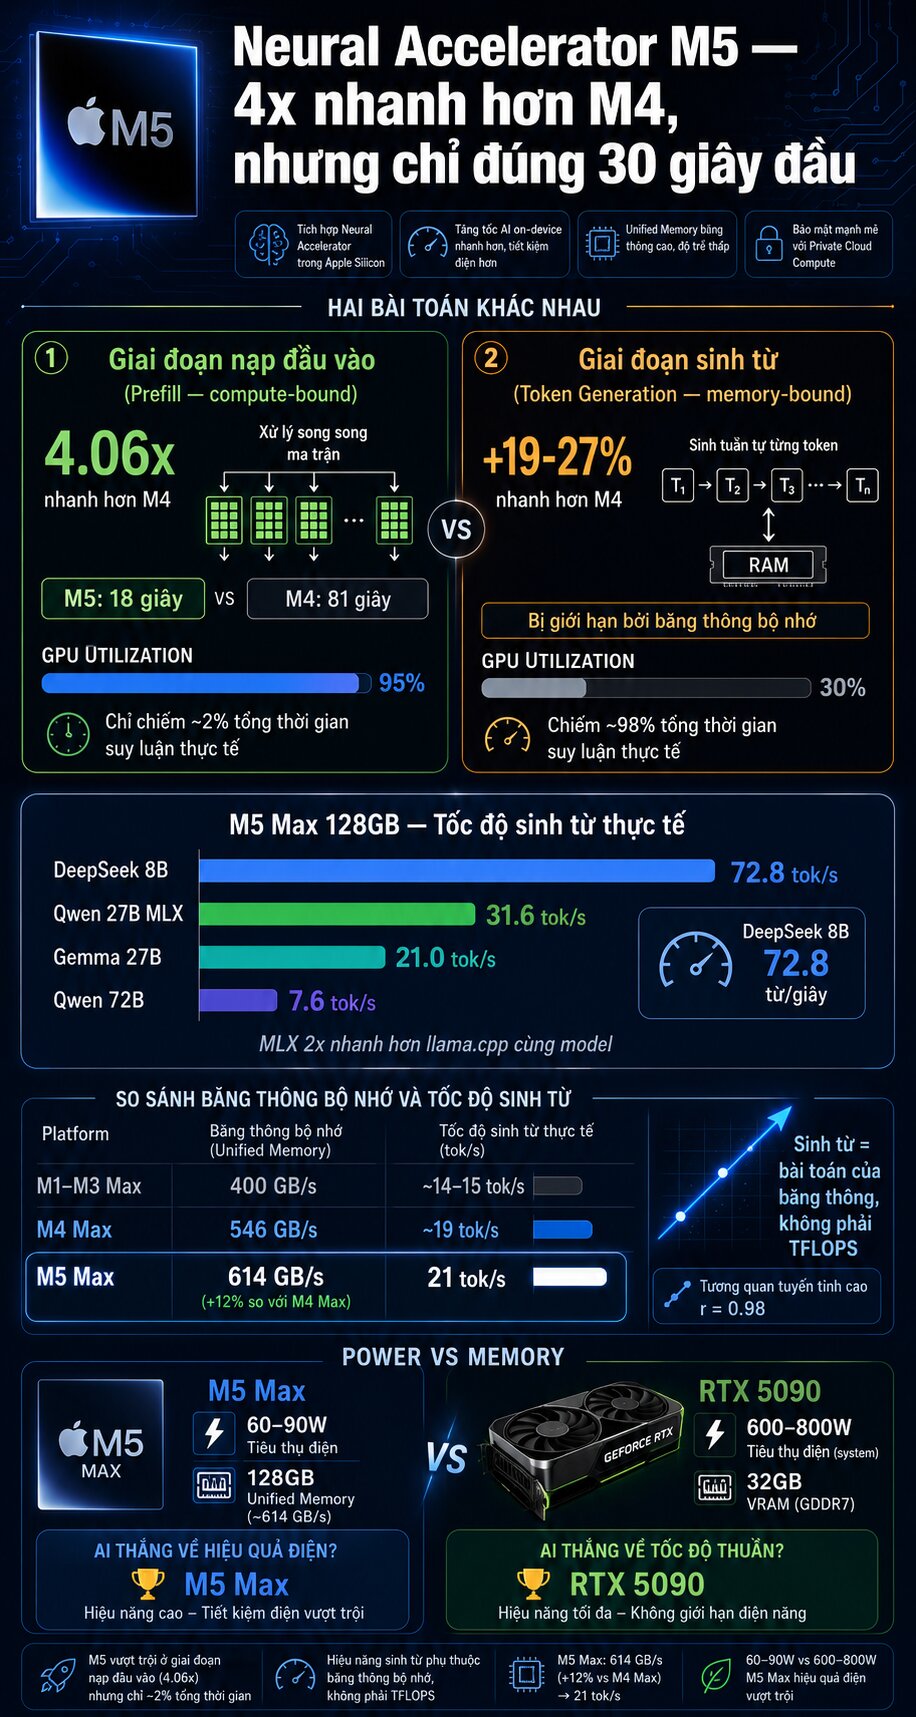
Giai đoạn nạp đầu vào - thời gian trước khi chữ đầu tiên xuất hiện: Chip nhận toàn bộ đoạn văn đầu vào của bạn và xử lý tất cả các từ song song với nhau trong một lượt. Tác vụ này đòi hỏi sức tính toán thô cực lớn - hàng tỷ phép nhân ma trận liên tiếp, GPU đạt mức sử dụng 90-95% (theo arxiv.org). Đây là sân chơi của Neural Accelerator. Kết quả đo lường từ Apple ML Research: cải thiện từ 3.33 đến 4.06 lần so với M4 — với mô hình Qwen3-14B-4bit và đoạn đầu vào 4.096 từ.
Giai đoạn sinh từ: Mô hình đặt ra từng chữ một theo thứ tự. Mỗi từ mới cần nạp lại toàn bộ hàng tỷ trọng số của mô hình từ RAM lên chip để tính. Tác vụ này không đòi hỏi nhiều phép tính thô - nhưng bị giới hạn hoàn toàn bởi tốc độ truyền dữ liệu từ bộ nhớ vật lý, GPU chỉ đạt mức sử dụng 20-40% (theo arxiv.org). Neural Accelerator có nhanh đến đâu cũng không giải quyết được cái nghẽn cổ chai này.
Quảng cáo
Công thức đơn giản: tốc độ sinh từ ≈ băng thông bộ nhớ ÷ dung lượng mô hình trên RAM. M5 Max có băng thông 614 GB/s (theo Apple). Mô hình DeepSeek-R1 8B sau lượng tử hóa (nén trọng số xuống 6-bit) chiếm khoảng 6.3 GB - giới hạn lý thuyết khoảng 97 từ/giây. Thực tế đo được 72.8 từ/giây, tức hiệu suất khai thác băng thông đạt ~75% (theo Reddit/LocalLLaMA).
M4 Max có băng thông 546 GB/s - tăng lên 614 GB/s trên M5 Max là +12% (theo Wikipedia). Và đúng như cơ chế trên suy ra, tốc độ sinh từ chỉ tăng 19-27%.
Có một con số từ bài so sánh độc lập mình thấy đáng để nhớ: trong một phiên hội thoại điển hình với đoạn đầu vào 12.000 từ và 500 từ đầu ra, giai đoạn nạp đầu vào chỉ chiếm khoảng 2% tổng thời gian chờ đợi (theo hardware-corner.net). Tức là 98% thời gian ngồi đợi là đang ở giai đoạn sinh từ - thứ Neural Accelerator không ảnh hưởng nhiều.
Điều này không có nghĩa Neural Accelerator vô dụng. Với prompt dài - kiểu đưa vào cả một tài liệu nhiều chục trang trước khi hỏi - việc nạp đầu vào từ 81 giây xuống 18 giây là trải nghiệm hoàn toàn khác. Nhưng nếu bạn chủ yếu chat với mô hình bằng các câu hỏi ngắn thì thứ bạn cảm nhận được trong thực tế gần với con số 19-27% hơn là 4 lần.
Test thực tế M5 Max 128GB - và câu đố tại sao MLX gần gấp đôi llama.cpp
Dưới đây là kết quả đo lường tốc độ sinh từ trên cấu hình M5 Max 128GB bộ nhớ thống nhất, macOS 26.3.1 (theo Reddit/LocalLLaMA):
Quảng cáo
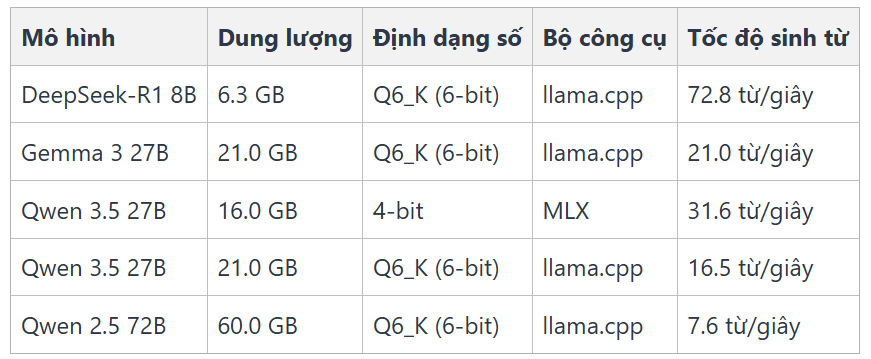
Anh em để ý khoảng cách giữa MLX và llama.cpp với cùng mô hình Qwen 3.5 27B: MLX đạt 31.6 từ/giây còn llama.cpp chỉ đạt 16.5 - gần gấp đôi. Lý do là llama.cpp hiện vẫn còn một số chỗ chưa tối ưu cho Apple Silicon, trong khi MLX được Apple phát triển riêng để khai thác trực tiếp các nhân Metal 4 đã tối ưu cho Neural Accelerator (theo Reddit/LocalLLaMA). Khoảng cách này sẽ thu hẹp dần khi llama.cpp cập nhật thêm.
Nhìn lại lịch sử tốc độ sinh từ qua các thế hệ chip Max thì xu hướng hiện ra rất rõ (theo Reddit/LocalLLaMA):
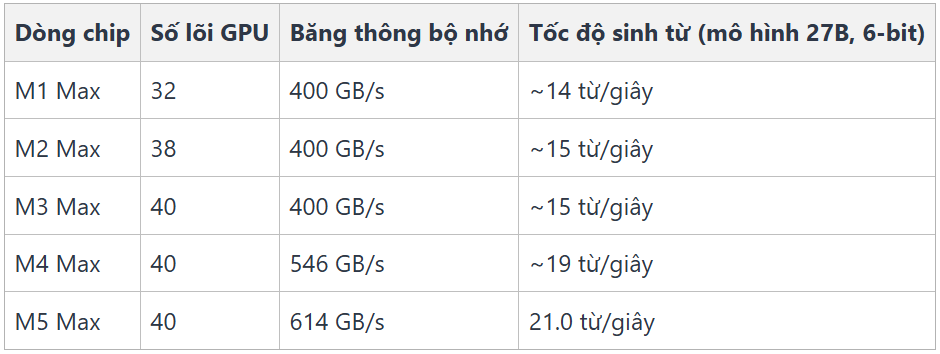
Từ M1 Max đến M3 Max: số lõi GPU tăng từ 32 lên 40, băng thông bộ nhớ không đổi ở 400 GB/s - tốc độ sinh từ gần như đứng yên. M4 Max tăng băng thông lên 546 GB/s - tốc độ sinh từ nhảy lên ~19. M5 Max tăng tiếp lên 614 GB/s - tốc độ tăng tỷ lệ.
Neural Accelerator không xuất hiện ở đâu trong bức tranh này - vì giai đoạn sinh từ không cần đến nó.
Metal 4 - lý do Neural Accelerator không chỉ là con số đo lường
Trong chip M5, Apple thiết kế ba lớp phần cứng xử lý AI hoàn toàn riêng biệt.
Đầu tiên là bộ đồng xử lý ma trận AMX nằm trong từng nhân CPU - chuyên cho các phép tính ma trận cần độ trễ thấp, tận dụng bộ đệm L1/L2 gần CPU nhất. Thứ hai là Neural Engine 16 nhân - phần cứng hiệu quả nhất về điện năng, thiết kế tối ưu cho các mạng nơ-ron tích chập thế hệ cũ. Thứ ba mới là GPU Neural Accelerator.
Neural Engine đã có rồi, tại sao cần thêm Neural Accelerator? Câu trả lời nằm ở chỗ Neural Engine là phần cứng đóng hoàn toàn - toàn bộ mô hình muốn chạy trên đó bắt buộc phải đi qua bộ công cụ Core ML của Apple. Các bộ công cụ mã nguồn mở phổ biến hiện nay - MLX, llama.cpp, Ollama - không thể tiếp cận trực tiếp Neural Engine (theo Skorppio). Người phát triển bị kẹt: Neural Engine thì nhanh nhưng đóng, còn đơn vị xử lý vector GPU cũ thì mở nhưng chậm với bài toán AI.
GPU Neural Accelerator giải quyết cái mâu thuẫn đó. Nằm trong luồng đồ họa mở của GPU, nó có thể lập trình trực tiếp qua Metal Shader - người phát triển viết các nhân tính toán tùy biến để khai thác phần cứng mà không bị ràng buộc bởi bộ biên dịch trung gian (theo Apple Developer Documentation).
Metal 4 đi kèm với hai cải tiến làm cho điều này có ý nghĩa thực dụng hơn chỉ là có phần cứng tốt.
Thứ nhất là Cooperative Tensors: thay vì ghi kết quả nhân ma trận ra bộ nhớ dùng chung rồi lại đọc lên, dữ liệu được phân bổ trực tiếp vào thanh ghi nội bộ của từng luồng SIMD đang tính. Kết quả nằm ngay tại chỗ - không cần một chuyến đi ra ngoài rồi quay vào (theo Apple Developer Documentation, WWDC 2025).
Thứ hai là Activation Fusion - gộp hàm kích hoạt (như ReLU, GELU) vào ngay trong bước nhân ma trận, trước khi dữ liệu được ghi ra đích cuối cùng. Thay vì nhân ma trận → ghi ra bộ nhớ → đọc lên → chạy ReLU → ghi ra, toàn bộ chuỗi đó thực hiện trong một lần đọc/ghi duy nhất (theo Apple Developer Documentation). Ít tốn băng thông, ít hao điện.
Kết quả thực tế: Apple ML Research đo được giai đoạn nạp đầu vào của mô hình Qwen3-14B-4bit được đẩy xuống dưới 10 giây - thứ mà M4 mất hơn 30 giây để làm (theo Apple ML Research, tháng 1/2026).
RTX 5090 và cái bẫy 32GB bộ nhớ đồ họa
Cộng đồng so sánh M5 Max với RTX 5090 nhiều đến mức mình thấy cần nói thẳng: đây không phải là một cuộc đua theo nghĩa thông thường.
RTX 5090 có sức mạnh tính toán thô vượt trội, hệ sinh thái CUDA thống trị tuyệt đối sau 15 năm phát triển. Trên Llama 3.1 70B lượng tử hóa 4-bit, RTX 5090 đạt 105 từ/giây - M5 Max chỉ đạt 65-88 từ/giây tùy ngữ cảnh (theo hardware-corner.net). Về tốc độ sinh từ thuần túy: RTX 5090 thắng.
Nhưng RTX 5090 chỉ có 32GB bộ nhớ đồ họa (VRAM). Mô hình 70 tỷ tham số - ngay cả sau lượng tử hóa 4-bit - chiếm khoảng 40GB (ước tính từ kích thước mô hình). Không vừa một card. Muốn chạy thì phải kết nối nhiều card qua khe cắm vật lý, độ trễ truyền dữ liệu giữa các card ăn mòn không nhỏ hiệu năng lý thuyết (theo Skorppio). Chi phí tăng theo cấp số nhân.
M5 Max 128GB bộ nhớ thống nhất chạy Qwen 2.5 72B thẳng một máy, không cần chia mảnh mô hình, không cần cấu hình gì thêm. Ngữ cảnh 64.000 từ? Tải được. RTX 5090 trong bài đo lường độc lập không tải được ngữ cảnh đó trong llama.cpp do giới hạn VRAM (theo hardware-corner.net).
Về tiêu thụ điện: M5 Max chạy toàn tải các mô hình AI vào khoảng 60-90W. Một hệ thống RTX 5090 cần 600-800W (theo Skorppio) - gấp 7-10 lần. Mình không nói RTX 5090 tệ - đó là công cụ khác, cho bài toán khác. Dù vậy, nếu mục tiêu là chạy mô hình lớn cục bộ trên một thiết bị di động, yên tĩnh và không cần ổ cắm 1.000W thì M5 Max đang giải quyết một bài toán mà RTX 5090 không tham gia.
Apple bỏ bản 256GB - tử tế hay khéo tay?
Khi MacBook Air M5 ra mắt với giá khởi điểm $1,099 thay vì $999, mình thấy không ít người nhảy vào kết luận: Apple đang tăng giá. Không hẳn, nhưng cũng không hẳn Apple đang tốt bụng hơn.
MacBook Air M4 bắt đầu từ $999 với ổ cứng 256GB. MacBook Air M5 bắt đầu từ $1,099 với ổ cứng 512GB. Nhưng Air M4 bản 512GB có giá $1,199 - tức là Air M5 cùng dung lượng thực ra rẻ hơn $100 (theo Macworld). MacBook Pro M5 Max 14" 2TB giá $3,599 - đúng bằng bản M4 Max nếu bạn nâng cấp lên 2TB (theo MacSales).
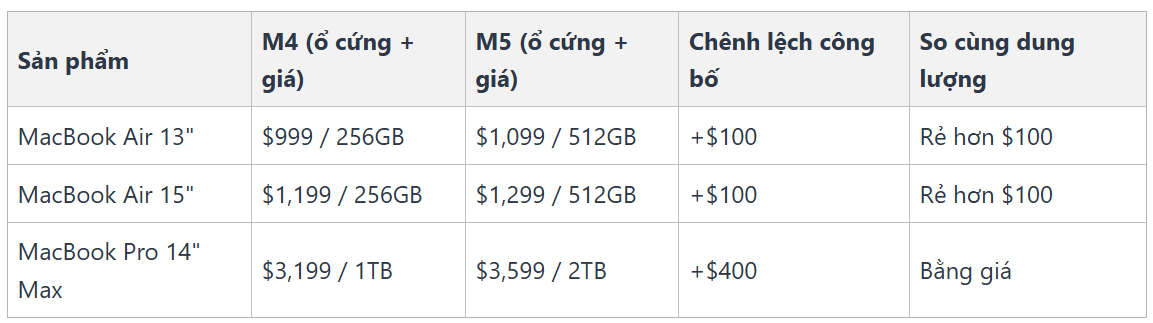
Thứ Apple thực sự làm là bỏ hoàn toàn các phiên bản ổ cứng thấp nhất - 256GB ở Air, 512GB ở Pro. Người mua mới không còn lựa chọn vào cửa ở mức giá sàn cũ. Kết quả là mức giá tối thiểu để sở hữu thiết bị bị nâng lên một bậc, dù về mặt kỹ thuật giá "cùng cấu hình" không tăng.
Logic từ phía Apple không vô lý: chip 3nm thế hệ thứ ba kết hợp công nghệ đóng gói hai phiến bán dẫn đắt hơn để sản xuất (theo Apple Newsroom). Biên lợi nhuận từ ổ cứng dung lượng cao giúp hấp thụ chi phí sản xuất tăng mà không ảnh hưởng đến lợi nhuận tổng. Và đúng là mô hình AI chạy cục bộ cần không gian lưu trữ - mô hình 27B lượng tử hóa 6-bit đã chiếm 21GB, bạn cần ổ cứng đủ lớn để chứa được vài mô hình cùng lúc (theo Apple Newsroom).
Nhưng nếu gọi đây là "vì người dùng cần dung lượng để chạy AI" thì đó là câu trả lời vừa đúng vừa tiện. Thực tế là Apple đang chuyển chi phí sản xuất sang người mua dưới dạng nâng cấp cấu hình bắt buộc. Khéo - nhưng không phải tử tế.
Ai thực sự cần Neural Accelerator, ai không cần
Người phát triển ứng dụng trên Metal 4 và MLX là nhóm hưởng lợi rõ nhất. Cooperative Tensors và Activation Fusion rút ngắn thời gian thử nghiệm mô hình. Giai đoạn nạp đầu vào nhanh hơn gần 4 lần nghĩa là vòng lặp kiểm tra nhanh hơn rất nhiều. Nếu bạn đang xây dựng ứng dụng AI trên nền tảng Apple thì M5 là bước nhảy kiến trúc đáng kể.
Người chạy mô hình lớn cục bộ: Nếu bạn thường xuyên đưa vào những đoạn văn bản dài - tài liệu, transcript, codebase — thì cải thiện giai đoạn nạp đầu vào từ Neural Accelerator cảm nhận được rõ. Tốc độ sinh từ tăng nhẹ theo băng thông. Phiên bản 128GB bộ nhớ thống nhất cho phép chạy các mô hình không vừa bất kỳ card đồ họa tiêu dùng nào hiện có.
Người làm nội dung dùng các công cụ AI: Topaz Video AI, Affinity Photo và các ứng dụng tương tự sẽ thấy cải thiện rõ - Topaz Video nhanh hơn 1.9 lần so với MacBook Air M4 (theo Apple Newsroom). Tính năng kết xuất hình ảnh dò tia (ray-tracing) của GPU cũng tăng 30-35% trên M5 Pro/Max (theo Apple Newsroom). Neural Accelerator hỗ trợ gián tiếp các tác vụ này qua Metal 4.
Người dùng thông thường: Nếu bạn chủ yếu dùng trình duyệt, xử lý văn bản, bảng tính, hay các ứng dụng chưa tích hợp Metal 4 - Neural Accelerator không tạo ra bất kỳ khác biệt nào trong trải nghiệm hằng ngày. Thứ bạn thực sự đang trả thêm tiền là ổ cứng lớn hơn và một chút băng thông bộ nhớ.
Câu hỏi thực tế mình hay gặp: "Có nên nâng cấp từ M4 lên M5 không?" - nếu bạn không thường xuyên chạy mô hình AI cục bộ hoặc xây dựng ứng dụng Metal thì câu trả lời gần như chắc chắn là chưa cần vội. Còn nếu đang dùng M1/M2 và thấy thời gian chờ trước khi mô hình phản hồi là vấn đề thực tế trong công việc, thì đây mới là lý do đáng cân nhắc thật sự.
Neural Accelerator không phải marketing. Đó là thay đổi kiến trúc phần cứng thực sự - tương tự bước chuyển dịch mà NVIDIA thực hiện với Tensor Core, giờ Apple mang vào GPU của mình. Sức mạnh tính toán cho giai đoạn nạp đầu vào tăng gần 4 lần là con số thật, có căn cứ từ cả Apple lẫn các bài đo lường độc lập.
Nhưng "4 lần" không áp dụng cho toàn bộ trải nghiệm chạy mô hình. Giai đoạn sinh từ - thứ bạn ngồi nhìn 98% thời gian - vẫn phụ thuộc chủ yếu vào băng thông bộ nhớ vật lý. Mức tăng 12% băng thông dẫn đến mức tăng 19-27% tốc độ sinh từ. Cải thiện đáng ghi nhận, nhưng không phải 4 lần.
Apple cũng rất khéo khi dùng câu chuyện "kỷ nguyên AI cục bộ" để hợp lý hóa việc bỏ các phiên bản ổ cứng thấp. Nhìn kỹ thì giá không tăng khi so cùng dung lượng - nhưng mức giá sàn để vào cửa thì đã cao hơn thật. Chiến lược kinh doanh tốt, không phải tệ - nhưng cũng không phải tử tế.
Nếu anh em đang cân nhắc và muốn trao đổi thêm về cấu hình phù hợp với nhu cầu thực tế, mình hay ghé hỏi macone.vn - họ khá rành về việc kết hợp nhu cầu thực tế với cấu hình chip phù hợp, không chỉ đọc lại bảng thông số.
Anh em đang chạy mô hình AI cục bộ trên Apple Silicon không? Neural Accelerator trên M5 có tạo ra khác biệt rõ trong công việc thực tế của bạn - hay vẫn thấy cái nghẽn cổ chai chính là băng thông bộ nhớ và dung lượng RAM, không phải sức tính toán?
#applesilicon #m5 #locallm #macbookpro #metal4 #macone #ai #chip
